Ist das Ihr Unternehmen? Profil übernehmen
Konfiguration, Bau und Integration von Hochleistungs-Servern, GPU-Systemen und HPC-/KI-Clustern für Forschung und Industrie
DELTA Computer Products GmbH
Glinde (DE)Neu auf Amplifa
Über DELTA Computer Products
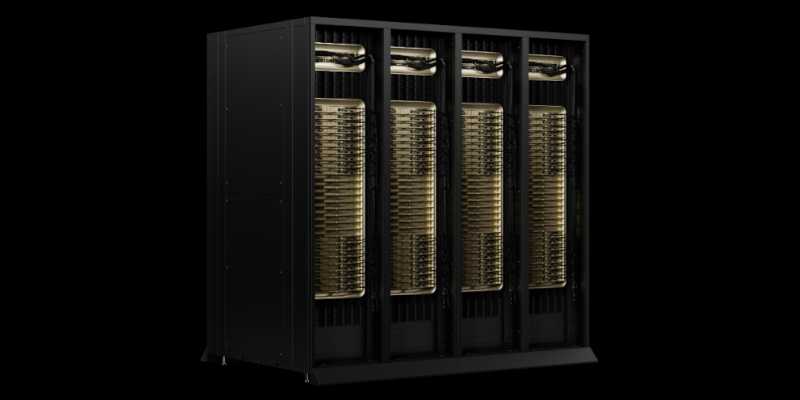
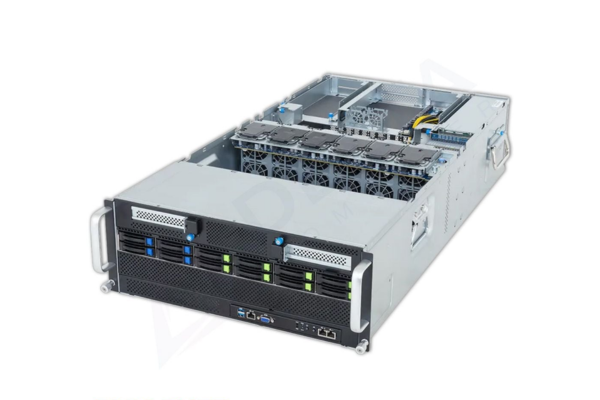
Die DELTA Computer Products GmbH mit Sitz in Glinde bei Hamburg entwickelt, konfiguriert und integriert Hochleistungs-IT-Infrastrukturen: Server (Rack-Chassis 1HE–4HE und Tower), GPU-Server bis zu acht GPU/MIC pro System, NVIDIA-DGX-Systeme, Workstations sowie skalierte Cluster- und SuperPOD-Lösungen auf Basis von Intel Xeon 6, AMD EPYC 9005, NVIDIA Grace Blackwell, InfiniBand- und Ethernet-Interconnects. Die Systeme werden aus Komponenten von SuperMicro, Quanta, Tyan, Asus und Gigabyte in Glinde montiert, jedem System unterzogen ein Stresstest mit HPL Linpack (mind. 48, max. 120 Stunden) sowie Firmware-Updates und Testinstallationen. Kunden sind Forschung und Lehre, Industrie, KI-/Deep-Learning-Umfelder und die öffentliche Hand; Referenzen umfassen DeepL SE, MTU Aero Engines, CERN, ETH Zürich und RWTH Aachen. DELTA ist NVIDIA Elite Partner und liefert europaweit und weltweit inklusive Installation, Rechenzentrumsanbindung und Support mit Reaktionszeit von 1–3 Stunden.
- Standort
- Glinde
- Verfahren
- Konfiguration und Bau von Hochleistungs-Servern (Rack-Server 1HE-4HE, Tower), GPU/MIC-Serverbau (bis zu 10 GPU-Adapter pro Chassis, bis 8x GPU/MIC, NVLink), Cluster-Systeme / HPC-Cluster-Integration, Hardware-Installation & Rechenzentrum-Anbindung, Qualitätssicherung: Stresstest der Systeme (HPL Linpack, Mindestens 48 Std., max. 120 Std. pro 1GB, Künstliche Intelligenz / Deep Learning / Machine Learning / HPC-Systemlösungen, Systemkonfiguration/Configurator, Qualitätssicherung inkl. Stresstest (HPL Linpack, 48–120h)
- Werkstoffe
- NVIDIA DGX B300 / B200 / H100 / GB300 Grace Blackwell Superchip, AMD EPYC 9005 Prozessoren, Intel Xeon 6 Prozessoren, NVIDIA Grace CPU Superchip, DDR5-RAM bis 6400 (bis 4096GB), NVMe/SATA/SAS HotSwap-Speicher, NVIDIA DGX (B300/B200/H100/GB200-NVL72), NVIDIA GB300 Grace Blackwell Ultra Desktop Superchip
- Zertifikate
- ISO 9001, ISO 14001, ISO 27001, IATF 16949, EN 9100
- Gegründet
- 1985
- Branchen
- High Performance Computing, Künstliche Intelligenz, Deep Learning, Machine Learning, Forschung & Lehre, Industrie
- 01
Anfrage & Beratung
- 02
Systemkonfiguration (Konfigurator)
- 03
Komponentenauswahl & Wareneingangsprüfung
- 04
Montage/Assemblierung in Glinde
- 05
Firmware-Update & Linux-Testinstallation
- 06
Stresstest (HPL Linpack, 48–120 h)
- 07
Messung von Stromverbrauch, Temperatur, Leistung
- 08
Versand (UPS / Kühne & Nagel, weltweit)
- 09
Installation & Rechenzentrumsanbindung
- 10
RMA-/Austauschservice & Support
Technologien & Komponenten
NVIDIA DGX (B300/B200/H100/GB200-NVL72)
Einheitliche KI-Plattformen mit 8× SXM-GPUs über NVLink für Deep-Learning-Training und Inferenz.
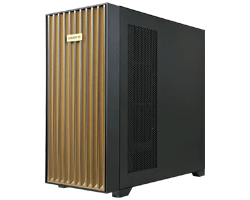
NVIDIA GB300 Grace Blackwell Ultra Desktop Superchip
Superchip für wassergekühlte GPU-Workstations mit 252 GB HBM3E.
Intel Xeon 6
Prozessoren (bis 350/500 W TDP) für Dual-Xeon-GPU-Server mit bis zu 4096 GB DDR5-6400.
AMD EPYC 9005
Prozessoren (bis 500 W TDP) für luftgekühlte Rack-Server bis 8× GPU/MIC.
NVIDIA Grace CPU Superchip
144-Core-CPU mit 480 GB LPDDR5X für Server mit bis zu 4× GPU.
DDR5-RAM bis 6400 (bis 4096 GB)
Arbeitsspeicher in 12–32 DIMM-Slots je nach Chassis.
NVMe/SATA/SAS HotSwap-Speicher
HotSwap-Speichermedien Gen4/Gen5 in 2,5"/3,5"-Bays und E1.S.
InfiniBand & Ethernet Interconnect
NDR/EDR-InfiniBand und 400/800GbE-Switches für Cluster-Vernetzung.
Standorte
Glinde
DEHauptsitz mit Montage, Qualitätssicherung und Test-Centre
- Losgröße
- Konfiguration ab Einzelstück bis Cluster-Scale
- Werkstoffe
- Intel Xeon 6, AMD EPYC 9005, NVIDIA DGX/Grace Blackwell, DDR5, NVMe
- Systemkonfigurator
- Stresstest-Umgebung (HPL Linpack)
- Test-Centre
- Wareneingangsprüfung mit Antistatik-/Klimabehandlung
Systeme & Produkte
Einblicke in die Fertigung
Branchen
Verfahren & technische Grenzen
| Verfahren | Toleranz | Max. Bauteil | Gewicht | Losgröße | Werkstoffe |
|---|---|---|---|---|---|
| Konfiguration und Bau von Hochleistungs-Servern (Rack-Server 1HE-4HE, Tower)Montage | – | – | – | – | Serverkomponenten (SuperMicro, Quanta, Tyan, Asus, |
| GPU/MIC-Serverbau (bis zu 10 GPU-Adapter pro Chassis, bis 8x GPU/MIC, NVLink)Montage | – | – | – | – | NVIDIA GPUs, Intel Xeon, AMD EPYC |
| Cluster-Systeme / HPC-Cluster-IntegrationMontage | – | – | – | – | NVIDIA DGX/GB200-NVL72, AMD Dual-EPYC, InfiniBand NDR/EDR |
| Hardware-Installation & Rechenzentrum-AnbindungMontage | – | – | – | – | – |
| Qualitätssicherung: Stresstest der Systeme (HPL Linpack, Mindestens 48 Std., max. 120 Std. pro 1GBPrüfung | – | – | – | – | – |
| Künstliche Intelligenz / Deep Learning / Machine Learning / HPC-SystemlösungenEngineering | – | – | – | – | – |
5 Anlagen & Maschinen
| Maschine | Hersteller / Modell | Anzahl | Arbeitsraum | Baujahr | Standort |
|---|---|---|---|---|---|
| Hochleistungs-Server (2HE Rack-Chassis, luftgekühlt) | DELTA (Basis SuperMicro, Quanta, Tyan, Asus, Gigabyte) D22x-M2-SP-4xGPU | – | 2x Intel Xeon 6 (max. 350W TDP), 32 DIMM (max. 4096GB DDR5-6400), bis 4x GPU/MIC | – | Glinde |
| Hochleistungs-Server (4HE Rack-Chassis, luftgekühlt) | DELTA D22x-M4-SP-8xGPU / D23z-M4-ZT-8xGPU | – | 2x Intel Xeon 6 bzw. 2x AMD EPYC 9005, bis 8x GPU/MIC (max. 600W TDP) | – | Glinde |
| GPU-Workstation (Tower, wassergekühlt) | DELTA / NVIDIA D15n-WK-GB-GB300-EDU | – | NVIDIA GB300 Grace Blackwell Ultra Desktop Superchip, 252GB HBM3E | – | Glinde |
| KI-Plattform (NVIDIA DGX) | NVIDIA DGX B300 2304GB | – | 8x NVIDIA SXM B300 288GB GPUs, 2x Intel Xeon 6776P, ~15kW max | – | Glinde |
| Ethernet/InfiniBand-Switches | NVIDIA, SuperMicro, Edge-corE, QuantaMesh, Netgear z. B. NVIDIA MSN5610 (64x 800GbE OSFP), MSN5400, MSN4700 | – | bis 64x 800GbE OSFP | – | Glinde |
Zusatzleistungen
Referenzkunden
Qualität & Zertifizierungen
Jedes System durchläuft unabhängig von Bauform und Wert einen Stresstest mit HPL Linpack (pro 1 GB RAM eine Stunde, mindestens 48, maximal 120 Stunden) inklusive Firmware-Updates, Testinstallation und Messung von Stromverbrauch, Temperaturen und Leistungswerten in Idle- und Lastszenarien. Konfigurationen werden auf Wunsch archiviert, sodass Nachbestellungen identische Rechner liefern.
| Nachweis | Glinde |
|---|---|
| ISO 9001 | |
| ISO 14001 | |
| ISO 27001 | |
| IATF 16949 | |
| EN 9100 |
Unternehmenshistorie
- 1985
Gründung als Anbieter von Hochleistungsservern und Speziallösungen für professionelle IT-Infrastrukturen.
- 1990
Etablierung als Spezialist für SMP-Server und Cluster-Systeme (1990er Jahre).
- 2000
Fokus auf numerische Simulation, Strömungsforschung und HPC-Workloads in Linux- und Windows-Umgebungen (2000er Jahre).
- 2010
Integration NVIDIA-GPU-beschleunigter Hochleistungsrechner; europaweite Lieferung von HPC- und Deep-Learning-Infrastrukturen.
- 2015
Erste Auslieferung von NVIDIA DGX-Systemen.
- 2018
NVIDIA Elite Partner; mehrfach Star Performer Central Europe.
- 2019
ML-/KI-Training-Cluster europaweit im Einsatz; Philip Hellmann tritt dem Unternehmen bei.
- 2023
Auslieferung von 100× NVIDIA DGX H100 (800× H100) an DeepL SE.
- 2024
HPC-Cluster mit 192× AMD Dual-EPYC (12.288 Cores) für MTU Aero Engines.
- 2025
40-jähriges Jubiläum, 8× NVIDIA DGX GB200-NVL72 für DeepL SE, Eröffnung des neuen Firmengebäudes in Glinde.