Ist das Ihr Unternehmen? Profil übernehmen
KI-basierte Sprachtrennung in Echtzeit auf Edge-Geräten für laute Industrieumgebungen.
VoxFocus
Neu auf Amplifa
Über VoxFocus
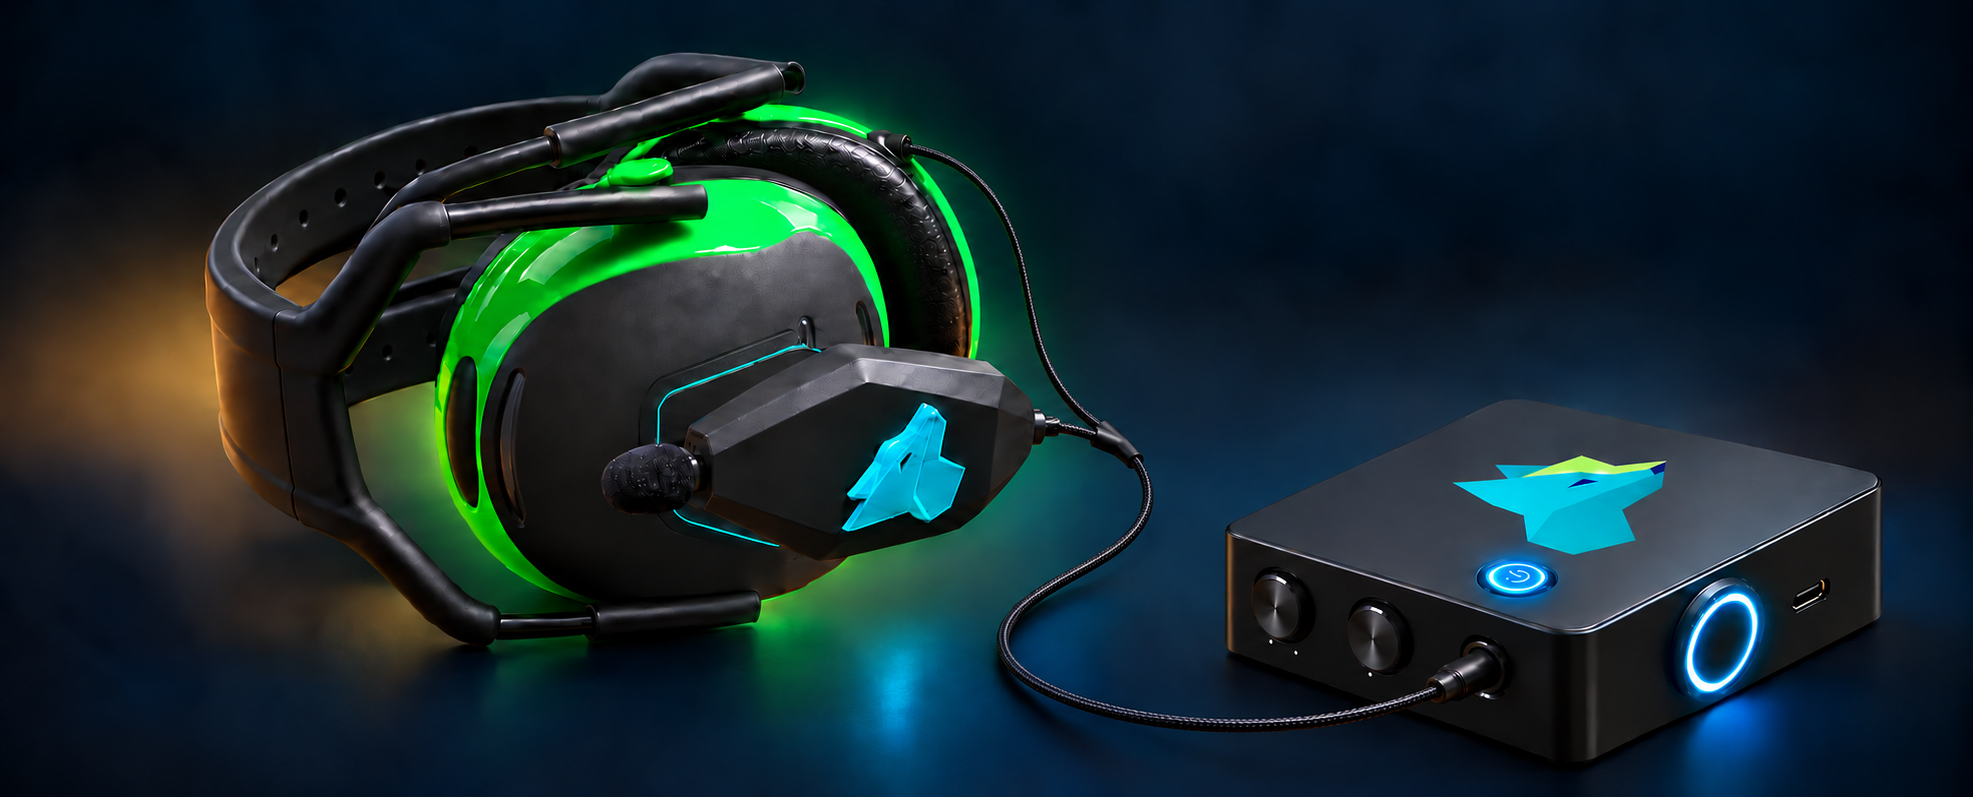
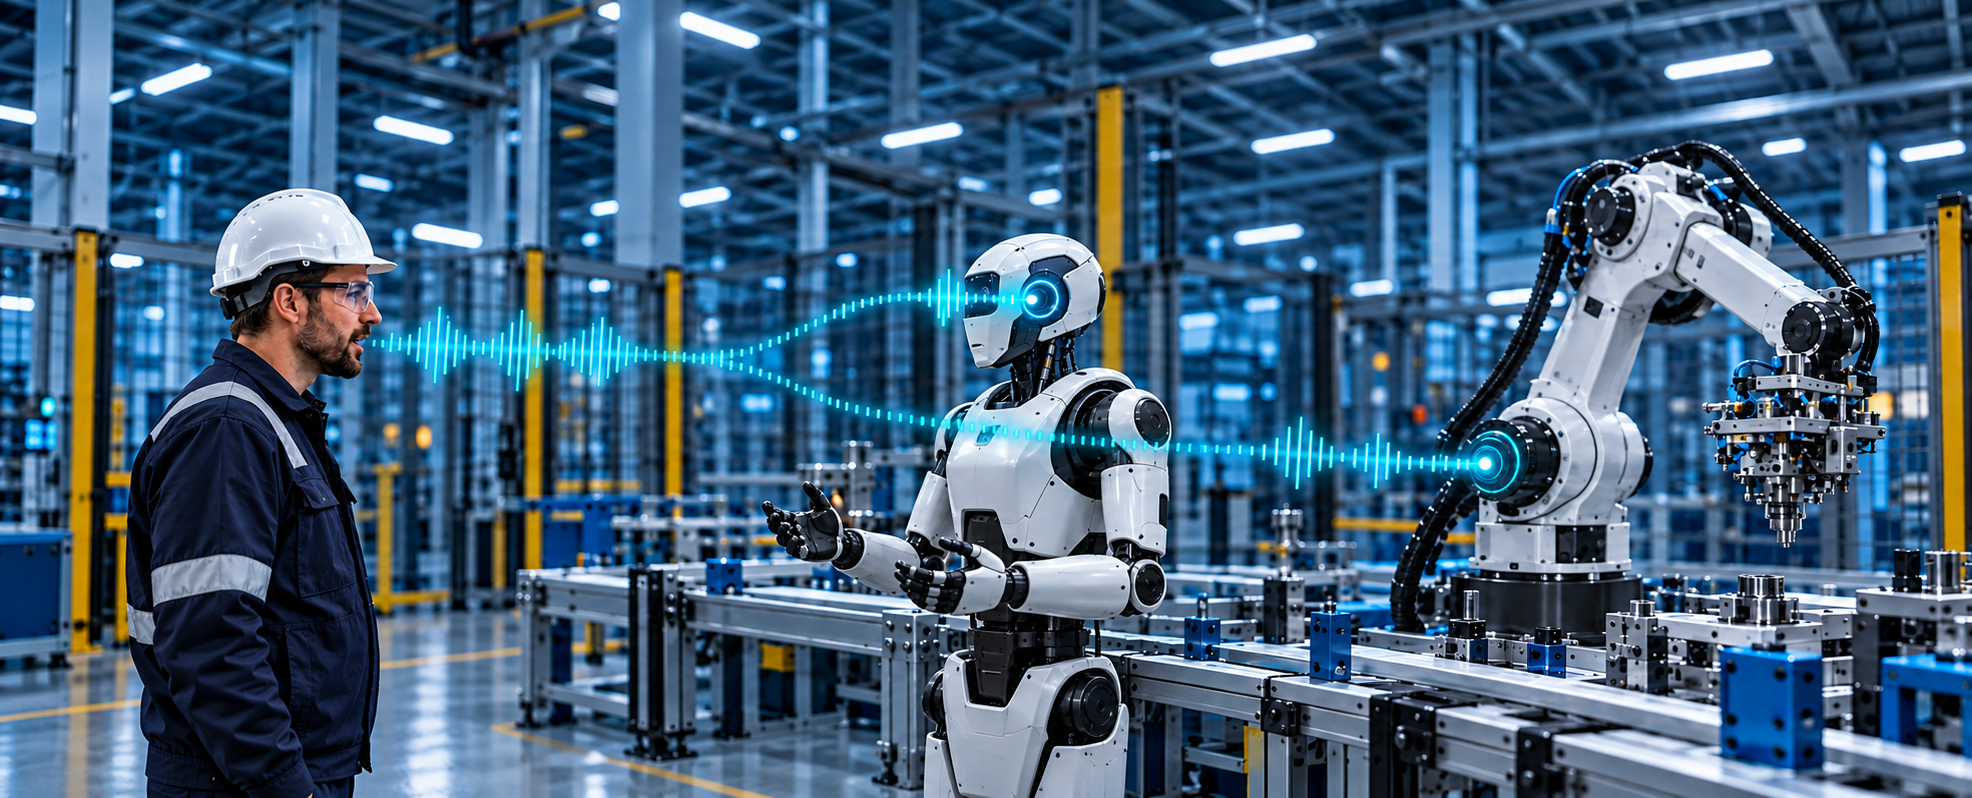
VoxFocus entwickelt eine KI-basierte Audio-Plattform zur Sprachtrennung: Der AI Audio Core trennt relevante Sprache in Echtzeit von Maschinen-, Werkzeug- und Umgebungsgeräuschen, bevor das Signal das Ohr oder digitale Sprachverarbeitungssysteme erreicht. Die Verarbeitung erfolgt lokal auf Edge-Geräten, d. h. ohne dauerhafte Cloud-Verbindung. Aus diesem gemeinsamen Kern entstehen zwei Produktwege: COMMAND ist eine Kommunikationsschicht für Gehörschutz (Hub plus Exciter, Prototyp), SENSE dient als akustische Frontend-Integration für Spracherkennung, HMI-Systeme und Robotik. Zielbranchen sind Fertigung, Maschinenbau, Robotik, Systemintegration sowie Hörschutz und Arbeitssicherheit. Die Leistung wird in Labor- und Feldtests zu Sprachverständlichkeit, Latenz, Wortfehlerrate und Robustheit validiert. VoxFocus ging aus einem Karaoke-Experiment zur Trennung von Stimme und Musik hervor und baut auf vier Jahren Forschung und Entwicklung auf.
- Verfahren
- KI-basierte Sprachtrennung (Speech Separation) in Echtzeit auf Edge-Geräten, AI Audio Core für Geräuschumgebungen, COMMAND: Kommunikationsschicht für Gehörschutz (Hub + Exciter, Prototyp), SENSE: akustische Frontend-Integration für Spracherkennung, HMI und Robotik, Labor- und Feldtests (Sprachverständlichkeit, Latenz, Wortfehlerrate), Software- und Modulintegration für Partnerprodukte
- Werkstoffe
- AI Audio Core (Edge-Verarbeitung), COMMAND – Kommunikationsschicht für Gehörschutz, SENSE – akustisches Frontend
- Branchen
- Industrie/Fertigung, Maschinenbau, Robotik, Systemintegration, Hörschutz/Arbeitssicherheit, Assistive Hörsysteme
- 01
Signalaufnahme (Mikrofon)
- 02
AI Audio Core: Sprachtrennung auf Edge-Geräten
- 03
Lieferung an Mensch (COMMAND) oder Sprachsystem (SENSE)
- 04
Labor- und Feldtests
- 05
Software- und Modulintegration für Partnerprodukte
Technologie & Verfahren
AI Audio Core (Edge-Verarbeitung)
Lokale, echtzeitfähige Sprachtrennung ohne dauerhafte Cloud-Verbindung.
COMMAND – Kommunikationsschicht für Gehörschutz
Prototyp bestehend aus Hub, Exciter und spezifiziertem Gehörschutz für laute Arbeitsplätze.
SENSE – akustisches Frontend
Vorbereitung von Sprache für bestehende Spracherkennung, HMI und Robotik.
Produkte & Anwendungen
Einblicke in die Fertigung
Branchen
Zusatzleistungen
Historie
- ~2021
Beginn als Karaoke-Experiment zur Trennung von Stimme und Musik während der Pandemie; vier Jahre Forschung & Entwicklung
- 2024
Erster Platz im Ideenwettbewerb Rheinland-Pfalz (Region Mainz, Reifegrad Stufe 1)
- 2025
Top 50 im Gründungswettbewerb – Digitale Innovationen (Winter 2025)
- 2025
AI Founder Fellowship (MISSION KI)
- 2025
Förderung durch das AI NATION Grant-Programm